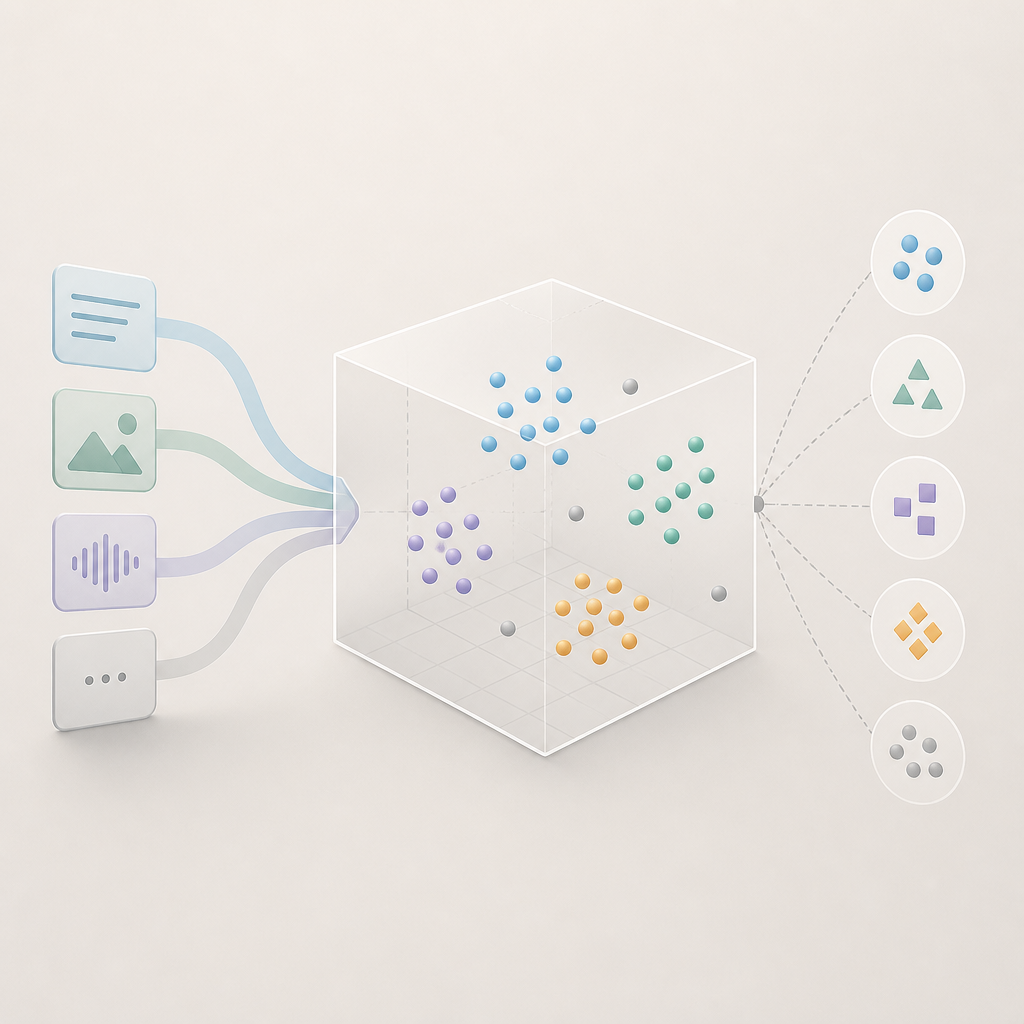
임베딩과 벡터 데이터베이스는 현대 데이터 처리와 분석에서 중요한 역할을 하고 있습니다. 이 글에서는 두 개념의 기본적인 정의와 그 활용 방법에 대해 알아보겠습니다.

임베딩이란 무엇인가?
임베딩은 고차원 데이터를 저차원 공간에 매핑하는 방법입니다. 이는 주로 자연어 처리(NLP)와 이미지 인식 분야에서 사용됩니다. 예를 들어, 단어 임베딩은 단어를 벡터로 변환하여 컴퓨터가 이해할 수 있게 합니다. 이 벡터는 단어 간의 유사성을 수치화하여 분석할 수 있게 도와줍니다. 임베딩을 통해 복잡한 데이터 구조를 간단하게 표현할 수 있어, 데이터 분석과 머신러닝 모델의 성능을 향상시킬 수 있습니다.
단어 임베딩의 대표적인 예로는 Word2Vec과 GloVe가 있습니다. Word2Vec은 단어의 문맥을 기반으로 벡터를 생성하며, GloVe는 전역적인 단어 공기행렬을 사용하여 벡터를 생성합니다. 이러한 임베딩 기법들은 단어 간의 의미적 유사성을 잘 포착하여, 유사한 의미를 가진 단어들이 벡터 공간에서 가까운 위치에 놓이도록 합니다.
벡터 데이터베이스의 역할
벡터 데이터베이스는 임베딩된 데이터를 효율적으로 저장하고 검색할 수 있는 시스템입니다. 전통적인 데이터베이스와 달리, 벡터 데이터베이스는 유사성 검색에 최적화되어 있습니다. 이는 대량의 데이터에서 특정 패턴이나 유사한 항목을 빠르게 찾는 데 유용합니다. 예를 들어, 이미지 검색 엔진은 벡터 데이터베이스를 사용하여 사용자가 업로드한 이미지와 유사한 이미지를 빠르게 찾아낼 수 있습니다.
벡터 데이터베이스는 특히 고차원 벡터를 다루는 데 강력한 성능을 발휘합니다. 예를 들어, Facebook의 FAISS(Facebook AI Similarity Search)는 대규모 데이터셋에서 유사한 벡터를 빠르게 검색할 수 있도록 설계되었습니다. 이는 대량의 이미지나 텍스트 데이터를 실시간으로 처리해야 하는 애플리케이션에서 필수적입니다.
임베딩과 벡터 데이터베이스의 상호작용
임베딩과 벡터 데이터베이스는 서로 보완적인 관계에 있습니다. 임베딩은 데이터를 벡터로 변환하여 벡터 데이터베이스에 저장할 수 있게 합니다. 이후 벡터 데이터베이스는 이러한 벡터를 기반으로 빠르고 효율적인 검색을 지원합니다. 이 과정은 대량의 데이터를 다루는 현대 애플리케이션에서 필수적입니다. 특히, 추천 시스템이나 개인화된 콘텐츠 제공 서비스에서 그 중요성이 더욱 부각됩니다.
예를 들어, 음악 스트리밍 서비스는 사용자의 청취 기록을 임베딩하여 벡터 데이터베이스에 저장합니다. 이를 통해 유사한 음악을 추천하거나, 사용자가 좋아할 만한 새로운 곡을 제안할 수 있습니다. 이러한 시스템은 사용자 경험을 향상시키고, 서비스의 가치를 높이는 데 기여합니다.
임베딩과 벡터 데이터베이스의 활용 사례
임베딩과 벡터 데이터베이스는 다양한 분야에서 활용되고 있습니다. 자연어 처리에서는 챗봇이나 번역 시스템에 사용되며, 이미지 처리에서는 얼굴 인식이나 객체 탐지에 활용됩니다. 또한, 추천 시스템에서는 사용자 행동을 분석하여 맞춤형 콘텐츠를 제공하는 데 사용됩니다. 이러한 기술은 데이터의 의미를 보다 깊이 이해하고, 사용자에게 더 나은 경험을 제공하는 데 기여합니다.
예를 들어, 전자상거래 플랫폼에서는 사용자의 구매 이력을 분석하여 관련 상품을 추천합니다. 이는 사용자의 관심사를 기반으로 한 개인화된 쇼핑 경험을 제공하며, 고객 만족도를 높이는 데 중요한 역할을 합니다. 또한, 소셜 미디어 플랫폼에서는 사용자의 활동 데이터를 임베딩하여 유사한 관심사를 가진 사용자들을 연결하거나, 맞춤형 광고를 제공하는 데 활용됩니다.
임베딩과 벡터 데이터베이스 사용 시 유의사항
임베딩과 벡터 데이터베이스를 사용할 때는 몇 가지 유의할 점이 있습니다. 첫째, 데이터의 품질이 중요합니다. 잘못된 데이터는 잘못된 임베딩을 생성할 수 있으며, 이는 전체 시스템의 성능에 영향을 미칠 수 있습니다. 둘째, 벡터 데이터베이스의 선택도 중요합니다. 각 데이터베이스는 특정한 검색 알고리즘과 최적화 기능을 제공하므로, 사용 목적에 맞는 데이터베이스를 선택하는 것이 중요합니다. 마지막으로, 데이터 보안과 프라이버시 문제도 고려해야 합니다. 특히, 개인 정보를 다루는 경우에는 적절한 보안 조치를 취해야 합니다.
또한, 임베딩의 차원 수를 적절히 설정하는 것도 중요합니다. 너무 낮은 차원은 정보 손실을 초래할 수 있고, 너무 높은 차원은 계산 복잡도를 증가시켜 성능 저하를 유발할 수 있습니다. 따라서, 데이터의 특성과 애플리케이션의 요구 사항에 맞춰 적절한 차원을 선택하는 것이 필요합니다.
참고 자료
임베딩과 벡터 데이터베이스에 대한 더 많은 정보를 얻고자 한다면, 다음의 자료를 참고할 수 있습니다.
- Mikolov et al., “Efficient Estimation of Word Representations in Vector Space”, 2013.
- Johnson et al., “Billion-scale similarity search with GPUs”, 2017.
- “Introduction to Neural Networks for Java”, Heaton Research, 2008.
FAQ
Q: 임베딩은 왜 필요한가요?
A: 임베딩은 고차원 데이터를 저차원 공간에 매핑하여 데이터의 유사성을 수치화하고 분석할 수 있게 돕습니다. 이는 데이터 분석과 머신러닝 모델의 성능을 향상시킵니다.
Q: 벡터 데이터베이스는 어떤 장점이 있나요?
A: 벡터 데이터베이스는 유사성 검색에 최적화되어 있어 대량의 데이터에서 특정 패턴이나 유사한 항목을 빠르게 찾을 수 있습니다.
Q: 임베딩과 벡터 데이터베이스를 사용할 때 주의할 점은 무엇인가요?
A: 데이터의 품질, 적절한 데이터베이스 선택, 데이터 보안 및 프라이버시 문제를 고려해야 합니다.
답글 남기기