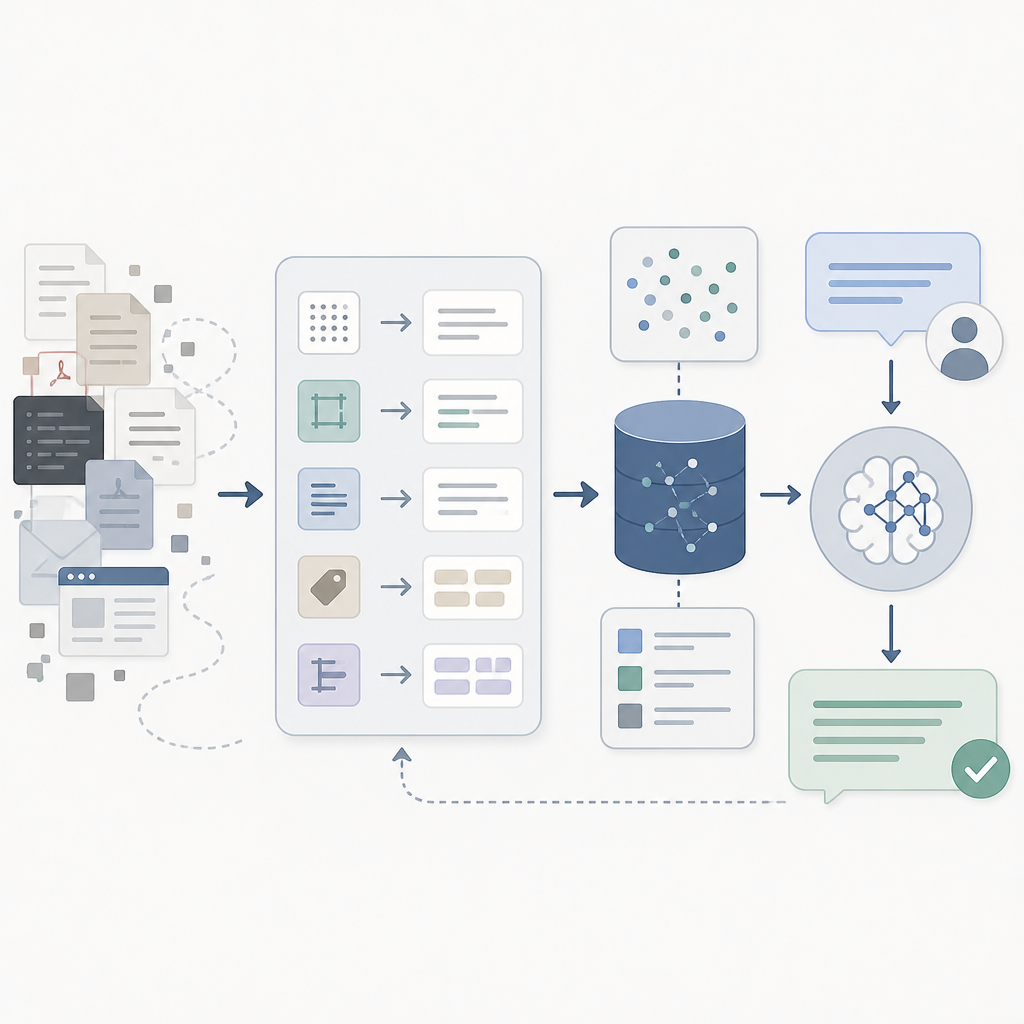
RAG(Recursively Augmented Generation) 모델은 자연어 처리 분야에서 주목받고 있는 기술입니다. 이 모델의 성능을 극대화하기 위해서는 문서 전처리가 필수적입니다. 문서 전처리는 데이터의 품질을 높이고, 모델이 더 정확하고 효율적으로 작동하도록 돕습니다. 이번 글에서는 RAG 모델 성능 개선을 위한 전처리 방법에 대해 알아보겠습니다.
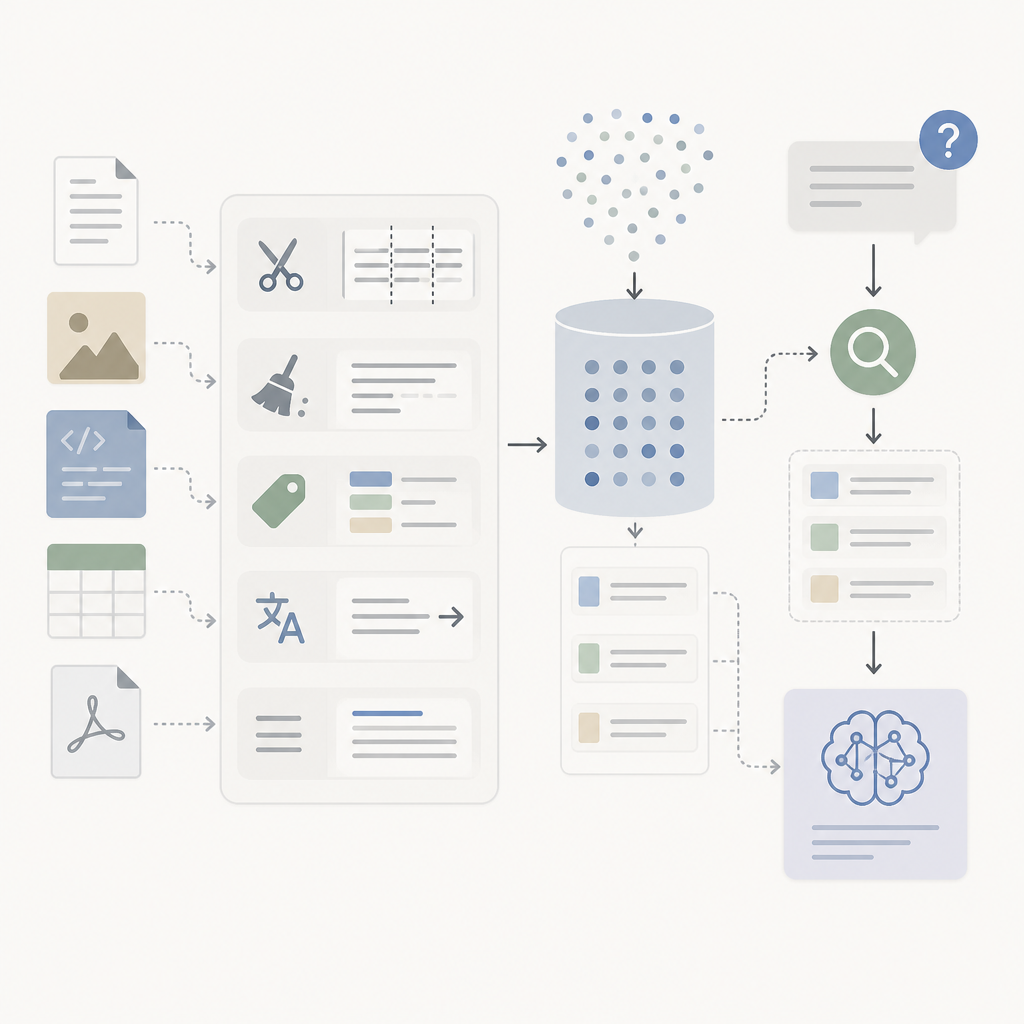
문서 전처리가 중요한 이유
RAG 모델은 대량의 데이터를 처리하여 질문에 대한 답변을 생성하는 데 사용됩니다. 하지만 원본 데이터가 정제되지 않으면 모델의 성능이 저하될 수 있습니다. 불필요한 정보나 오류가 포함된 데이터는 모델이 잘못된 결과를 생성하게 할 수 있습니다. 따라서 문서 전처리를 통해 데이터를 정리하고, 필요한 정보만을 남기는 것이 중요합니다.
효과적인 문서 전처리 방법
문서 전처리에는 여러 가지 방법이 있습니다. 가장 기본적인 방법으로는 불필요한 공백 제거, 특수 문자 삭제, 그리고 데이터의 일관성을 유지하기 위한 형식 통일 등이 있습니다. 또한, 텍스트의 의미를 왜곡하지 않으면서 불필요한 부분을 제거하는 것이 필요합니다. 이를 통해 모델이 중요한 정보에 집중할 수 있도록 돕습니다.
RAG 품질을 높이는 데이터 준비
데이터 준비 단계에서는 데이터의 품질을 높이기 위한 다양한 기법을 사용할 수 있습니다. 예를 들어, 중복 데이터를 제거하거나, 데이터의 양을 조절하여 모델이 과적합되지 않도록 하는 것이 중요합니다. 또한, 데이터의 다양성을 확보하여 모델이 다양한 상황에서도 일관된 성능을 발휘할 수 있도록 해야 합니다.
문서 전처리와 RAG 모델의 관계
문서 전처리는 RAG 모델의 성능에 직접적인 영향을 미칩니다. 잘 정제된 데이터는 모델이 더 빠르고 정확하게 학습할 수 있도록 돕습니다. 반대로, 전처리가 부족한 데이터는 모델의 학습을 방해하고, 결과의 신뢰성을 떨어뜨릴 수 있습니다. 따라서 전처리는 RAG 모델의 성공적인 구현을 위한 필수적인 과정입니다.
주의사항
문서 전처리를 할 때는 데이터의 의미를 왜곡하지 않도록 주의해야 합니다. 과도한 전처리는 오히려 중요한 정보를 손실시킬 수 있습니다. 또한, 전처리 과정에서 발생할 수 있는 오류를 최소화하기 위해 자동화된 도구를 사용하는 것도 좋은 방법입니다. 하지만, 최종적으로는 사람이 직접 검토하여 데이터의 품질을 확인하는 것이 필요합니다.
FAQ
Q1: RAG 모델에서 전처리가 중요한 이유는 무엇인가요?
전처리는 데이터의 품질을 높여 모델이 더 정확하고 효율적으로 작동하도록 돕습니다. 불필요한 정보나 오류가 포함된 데이터는 모델의 성능을 저하시킬 수 있습니다.
Q2: 문서 전처리에서 가장 기본적인 방법은 무엇인가요?
가장 기본적인 방법으로는 불필요한 공백 제거, 특수 문자 삭제, 데이터의 일관성을 유지하기 위한 형식 통일 등이 있습니다.
Q3: 전처리 과정에서 주의해야 할 점은 무엇인가요?
전처리 과정에서 데이터의 의미를 왜곡하지 않도록 주의해야 하며, 과도한 전처리는 중요한 정보를 손실시킬 수 있습니다.
관련 글